william@devops:~$ cat projetos.md

PROJETOS / ESTUDOS DE CASO

O que encontrei,
o que fiz.

Projetos de Cloud, DevOps e segurança contados do jeito que aconteceram: o problema, o que eu fiz e o que mudou. Sem nome de empresa nem dado sensível.

Feitos em produção, nas empresas em que trabalhei. Como o ambiente de cliente não pode aparecer, os prints e trechos de código vêm de uma reprodução fiel no meu laboratório, sem nenhum dado das empresas.

01

PLATAFORMA · IaC · SEGURANÇA

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Da herança ao deploy sem senha: modernizando uma plataforma AWS com Terraform
Peguei 41 módulos Terraform herdados, cheios de atalhos perigosos, e transformei numa base segura. A prova foi uma aplicação real indo para o ar sozinha.

DESAFIO

Recebi uma base de módulos herdada de um ambiente corporativo. Logo na primeira olhada apareceram senhas em texto puro, access keys fixas nos pipelines, módulos sem versão e até um que nunca tinha funcionado. Antes de criar qualquer coisa nova, eu precisava entender o que tinha nas mãos.

SOLUÇÃO

Comecei auditando os 41 módulos, um por um, e organizei o trabalho em 4 ondas: limpar, proteger, versionar e padronizar. Para provar que funcionava de verdade, criei um app piloto e fiz o primeiro deploy. Nada passou de primeira: o GitHub não achava o workflow, a AWS recusava o login, o scanner barrava a imagem. Cada erro virou um ajuste no módulo, não um remendo no projeto.

RESULTADO

Hoje, um push na branch certa coloca o site no ar em menos de 2 minutos, sem nenhuma senha guardada no GitHub. Se alguém tentar publicar pela branch errada, a própria AWS recusa. E a imagem da API saiu de 26 vulnerabilidades para zero.

.github/workflows/deploy.yml•••

01name: "Deploy Front"

02on:

03  push:

04    branches: [develop]

05permissions:

06  contents: read

07  # OIDC: login na AWS sem access key

08  id-token: write

09jobs:

10  deploy:

11    # a esteira inteira mora no módulo

12    uses: minha-org/workflows/deploy-frontend.yml@v2.0.0

13    with:

14      application_name: app-front

15      node_version: "22"

16      config_secret_base_name: app-front/config

17      build_output_dir: dist

mainUTF-8Ln 17

Código real do projeto

Dentro do workflow central: login na AWS por OIDC, publicação no S3 e limpeza do cache do CloudFront.

deploy:
  needs: [build]
  runs-on: ubuntu-latest
  steps:
    - name: Configurar credenciais AWS via OIDC
      uses: aws-actions/configure-aws-credentials@v4
      with:
        role-to-assume: ${{ vars.AWS_ROLE_ARN }}
        aws-region: ${{ inputs.aws_region }}
        role-session-name: deploy-${{ github.run_id }}
        role-duration-seconds: 1800      # credencial vale 30 min e expira sozinha
        mask-aws-account-id: true

    - name: Publicar no S3
      run: |
        aws s3 sync "dist/" "${DESTINATION}" \
          --delete \
          --cache-control "${CACHE_CONTROL}" \
          --only-show-errors

    - name: Limpar cache do CloudFront
      run: |
        aws cloudfront create-invalidation \
          --distribution-id "${DISTRIBUTION_ID}" \
          --paths "/*"
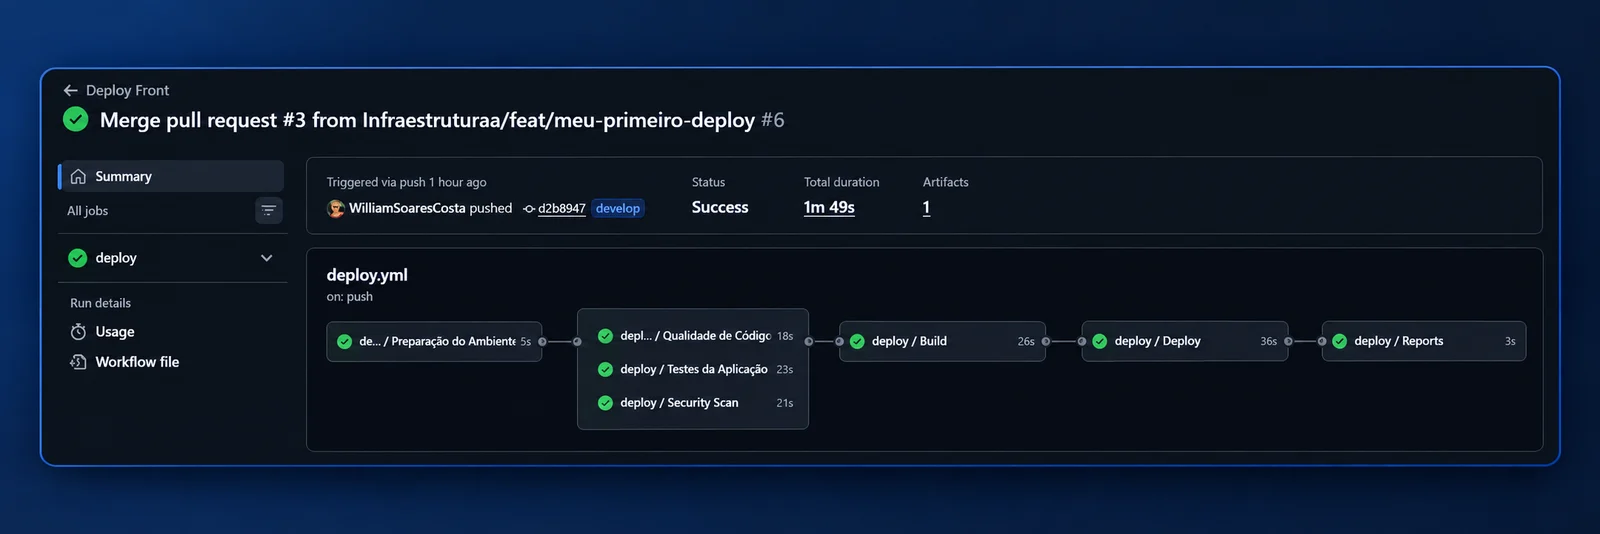
Execução do pipeline no GitHub Actions com todas as etapas concluídas com sucesso em 1 minuto e 49 segundos
Execução real: preparação, qualidade, testes e segurança em paralelo, build, deploy e relatório, em 1m49s.
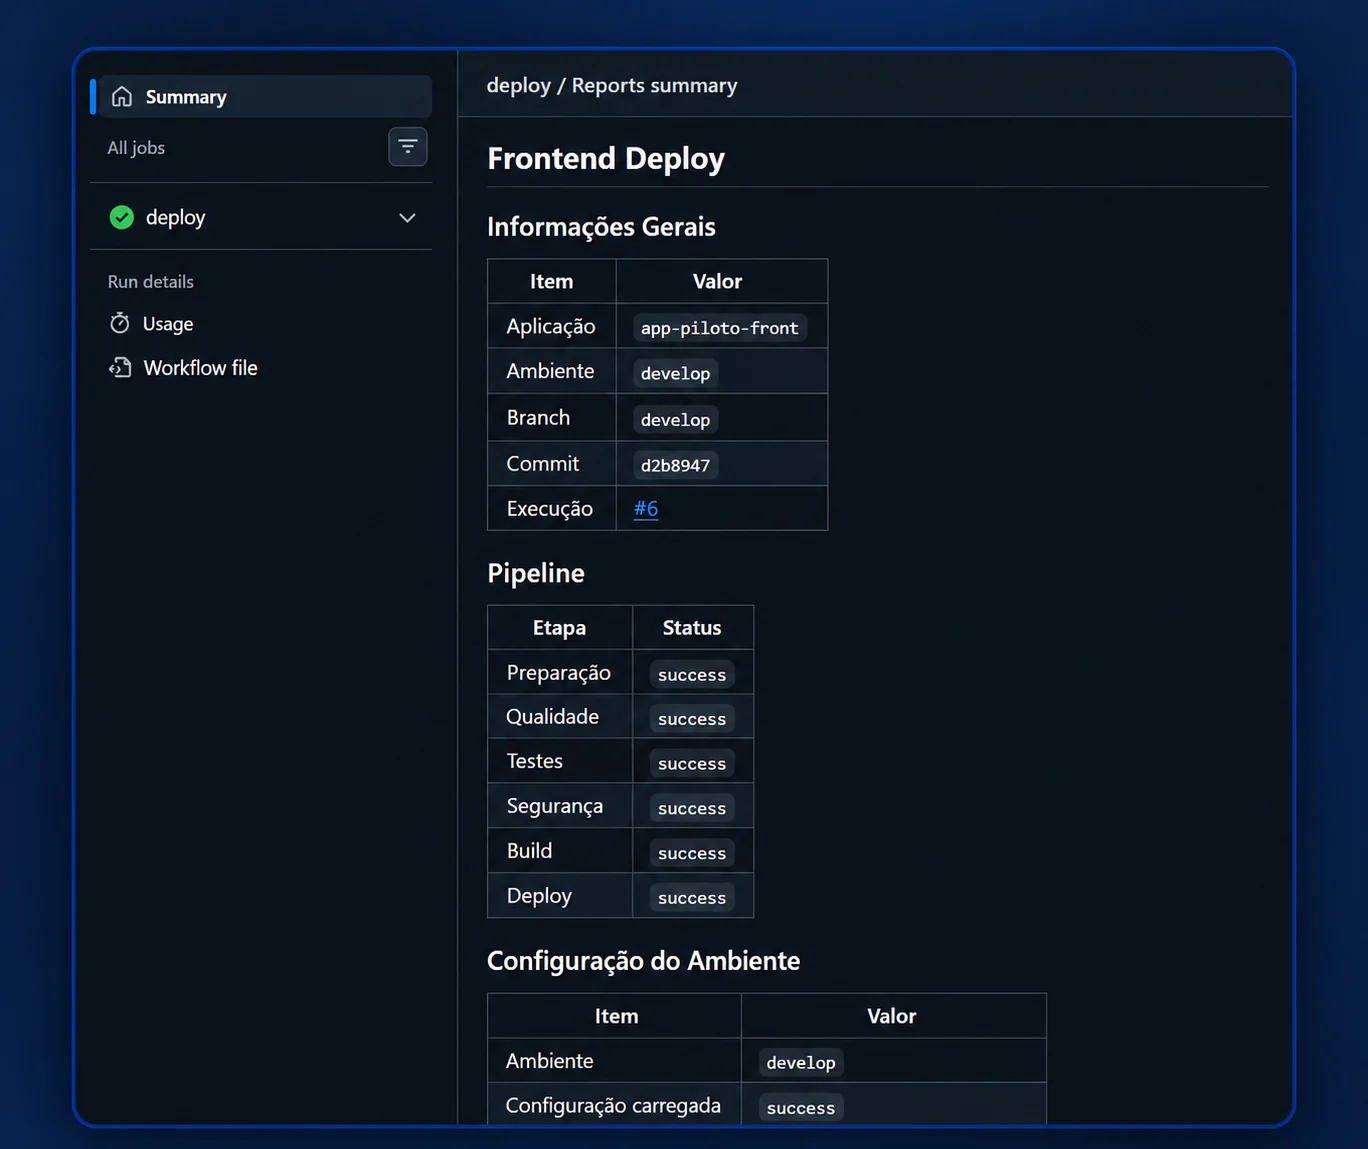
Relatório automático do deploy com aplicação, ambiente, commit e o status de cada etapa
Relatório gerado automaticamente ao fim de cada deploy.
TerraformAWS OIDCGitHub ActionsS3 + CloudFrontECRTrivy
02

KUBERNETES · AWS · CUSTO

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Kubernetes na AWS com acesso seguro e custo sob controle

Um cluster EKS que sobe e desce em minutos, com acesso por role (não por usuário), nós protegidos e custo perto de zero quando não está em uso.

DESAFIO

Descobri na prática que ser administrador da AWS não é ser administrador do Kubernetes: o console mostrava "Unauthorized" nos nós. Eles também subiam sem nome, sem tags e com disco sem criptografia. E um ambiente de estudo ligado o tempo todo custava caro.

SOLUÇÃO

Criei uma role de administrador do cluster, com o mínimo de permissão, que só quem é autorizado consegue assumir, em vez de liberar usuário por usuário. Os nós passaram a usar um launch template com IMDSv2 obrigatório, disco gp3 criptografado, Amazon Linux 2023 e tags padronizadas. Para o custo: um único NAT no ambiente de estudo e o hábito de destruir tudo com um checklist no final.

RESULTADO

Cerca de 70 recursos criados em uns 14 minutos e destruídos sem sobrar nada cobrando. O acesso ficou rastreável por role, e os nós saem padronizados e protegidos desde o primeiro boot.

eks.yaml•••

01cluster:

02  versao: "1.35"

03  acesso:

04    metodo: access_entries

05    admin: "role/eks-admin" # só quem está autorizado

06    usuarios_diretos: 0

07  nos:

08    ami: amazon_linux_2023

09    imds: v2_obrigatorio

10    disco: gp3_criptografado

11    tags: padronizadas

12  custo:

13    nat: 1 # estudo: 1 NAT basta

14    destroy_checklist: "tudo []"

15status: "sobe_e_desce_em_minutos"

mainUTF-8Ln 15

Código real do projeto

Acesso ao cluster por role da AWS (access entries), sem usuário cadastrado no aws-auth.

resource "aws_eks_cluster" "this" {
  # ...
  access_config {
    authentication_mode = "API"   # acesso só por access entries
  }
  deletion_protection = var.deletion_protection
}

resource "aws_eks_access_entry" "additional" {
  for_each = var.access_entries

  cluster_name  = aws_eks_cluster.this.name
  principal_arn = each.value.principal_arn   # uma role, não um usuário
}

resource "aws_eks_access_policy_association" "additional" {
  for_each = var.access_entries

  cluster_name  = aws_eks_cluster.this.name
  principal_arn = each.value.principal_arn
  policy_arn    = each.value.policy_arn

  access_scope {
    type = "cluster"
  }
}
Amazon EKSTerraformIAMLaunch TemplateIMDSv2
03

GITOPS · KUBERNETES · CI/CD

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Backend no EKS com GitOps: o Git manda, o Argo CD aplica

O pipeline não faz deploy no cluster. Ele publica a imagem e muda uma linha no repositório GitOps; o Argo CD percebe a mudança e sincroniza o Kubernetes sozinho.

DESAFIO

Com várias APIs e quatro ambientes, deploy feito direto do pipeline com kubectl deixa o cluster sem histórico claro: ninguém sabe ao certo o que está rodando, rollback é manual e o pipeline precisa de credencial de administrador do cluster. No Argo CD, cada aplicação nova ainda entrava aplicando a Application à mão, e algumas configurações sensíveis viajavam junto dos manifests.

SOLUÇÃO

Separei o caminho em dois. O GitHub Actions testa, faz o build, passa a imagem no Trivy, publica no ECR (login por OIDC) e atualiza a tag no kustomization.yaml do ambiente, num repositório GitOps. O Argo CD, instalado como código, observa esse repositório e aplica no EKS. Automatizei o onboarding com app of apps e ApplicationSet: aplicação nova é uma pasta no Git, sem passo manual. E tirei as credenciais dos manifests: cada aplicação tem o seu ServiceAccount com IRSA e recebe da AWS uma credencial temporária só com as permissões dela.

RESULTADO

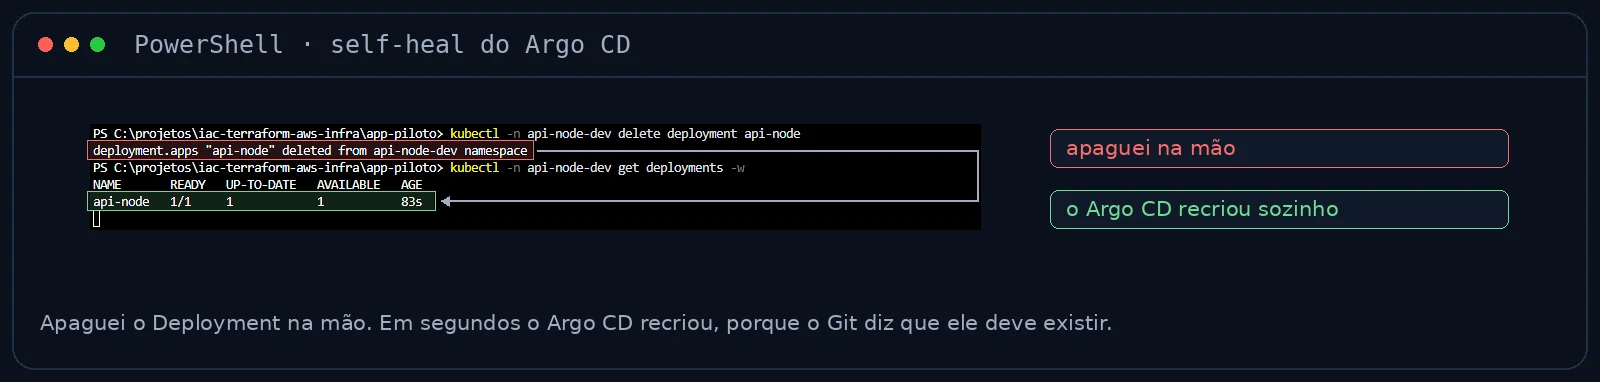
Tudo que roda no cluster está descrito no Git: cada deploy é um commit, com autor e data, e rollback é um git revert. Aplicação nova entra no cluster com um merge, sem nenhum passo manual no Argo CD, e nenhuma credencial fica no Git ou nos manifests. O pipeline não tem acesso ao cluster, e o Argo CD corrige sozinho qualquer mudança feita na mão (testado: apaguei um Deployment e ele voltou em segundos). Com o metrics-server como add-on, a API escala de 2 para 4 pods sozinha.

fluxo.yaml•••

01fluxo:

02  - push na branch

03  - testes | build | trivy

04  - imagem no ECR (tag = commit)

05  - commit no repo gitops

06  - argo cd sincroniza o EKS

07ambientes:

08  develop: dev

09  release/*: hml

10  main: prd

11pipeline_acessa_cluster: false

12rollback: "git revert"

13status: "git_e_a_fonte_da_verdade"

mainUTF-8Ln 13

Código real do projeto

O repositório da API só chama o workflow do módulo e diz onde fica o GitOps. O token tem escrita apenas no repositório GitOps.

name: Deploy API

on:
  push:
    branches: [develop, "release/*", main]
  workflow_dispatch:

permissions:
  contents: read
  id-token: write          # OIDC para publicar no ECR, sem access key

jobs:
  deploy:
    uses: minha-org/workflows/.github/workflows/deploy-eks-node.yml@v2.0.0
    with:
      app_name: minha-api
      product_name: loja
      node_version: "22"
      update_gitops: true
      gitops_repository: minha-org/gitops
      gitops_deployment_root: apps/minha-api/overlays
    secrets:
      GITOPS_TOKEN: ${{ secrets.GITOPS_TOKEN }}   # escrita SÓ no repo GitOps
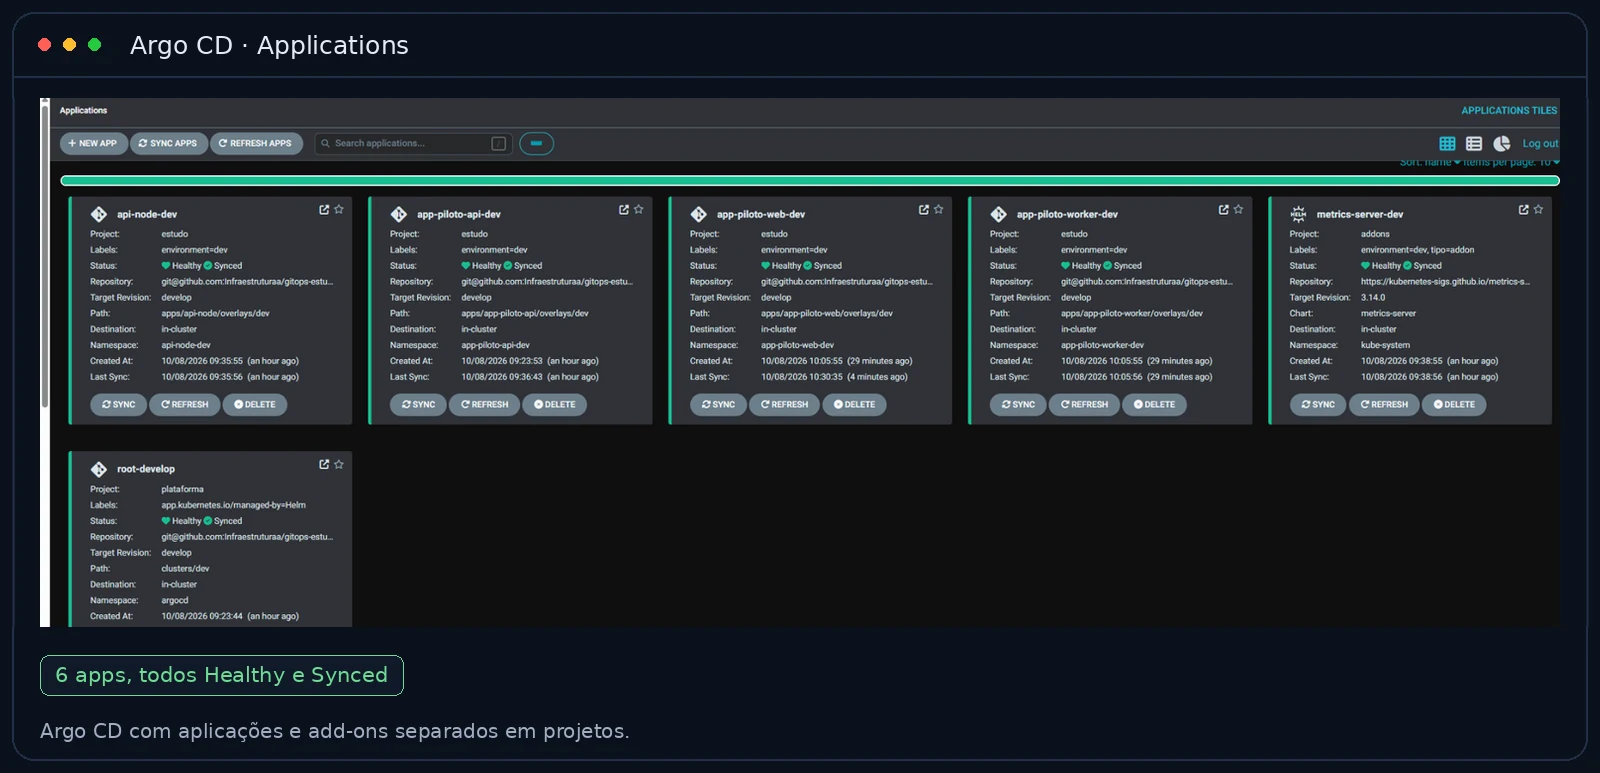
Argo CD com seis aplicações, todas Healthy e Synced, separadas nos projetos estudo, addons e plataforma
Segunda rodada do laboratório: seis apps (aplicações e add-ons em projetos separados), todos Healthy e Synced.
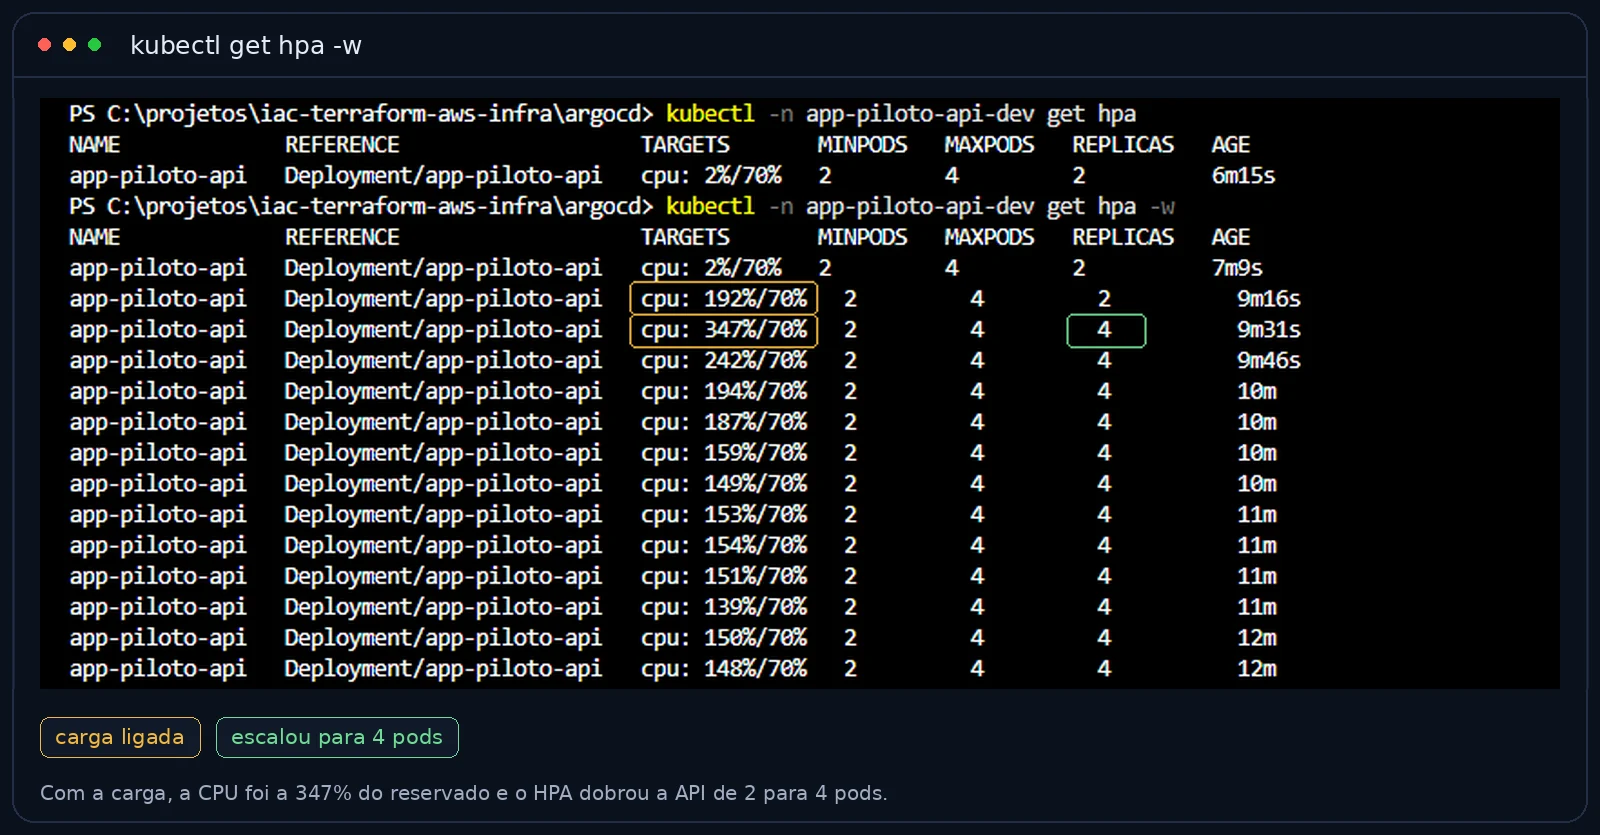
Saída do kubectl get hpa mostrando a CPU subindo para 347 por cento e as réplicas indo de 2 para 4
Autoscaling: com carga, a CPU foi a 347% do reservado e o HPA dobrou a API de 2 para 4 pods.
Terminal com o Deployment api-node apagado e, logo depois, recriado pelo Argo CD
Self-heal: apaguei o Deployment na mão e o Argo CD recriou em segundos, porque o Git diz que ele deve existir.
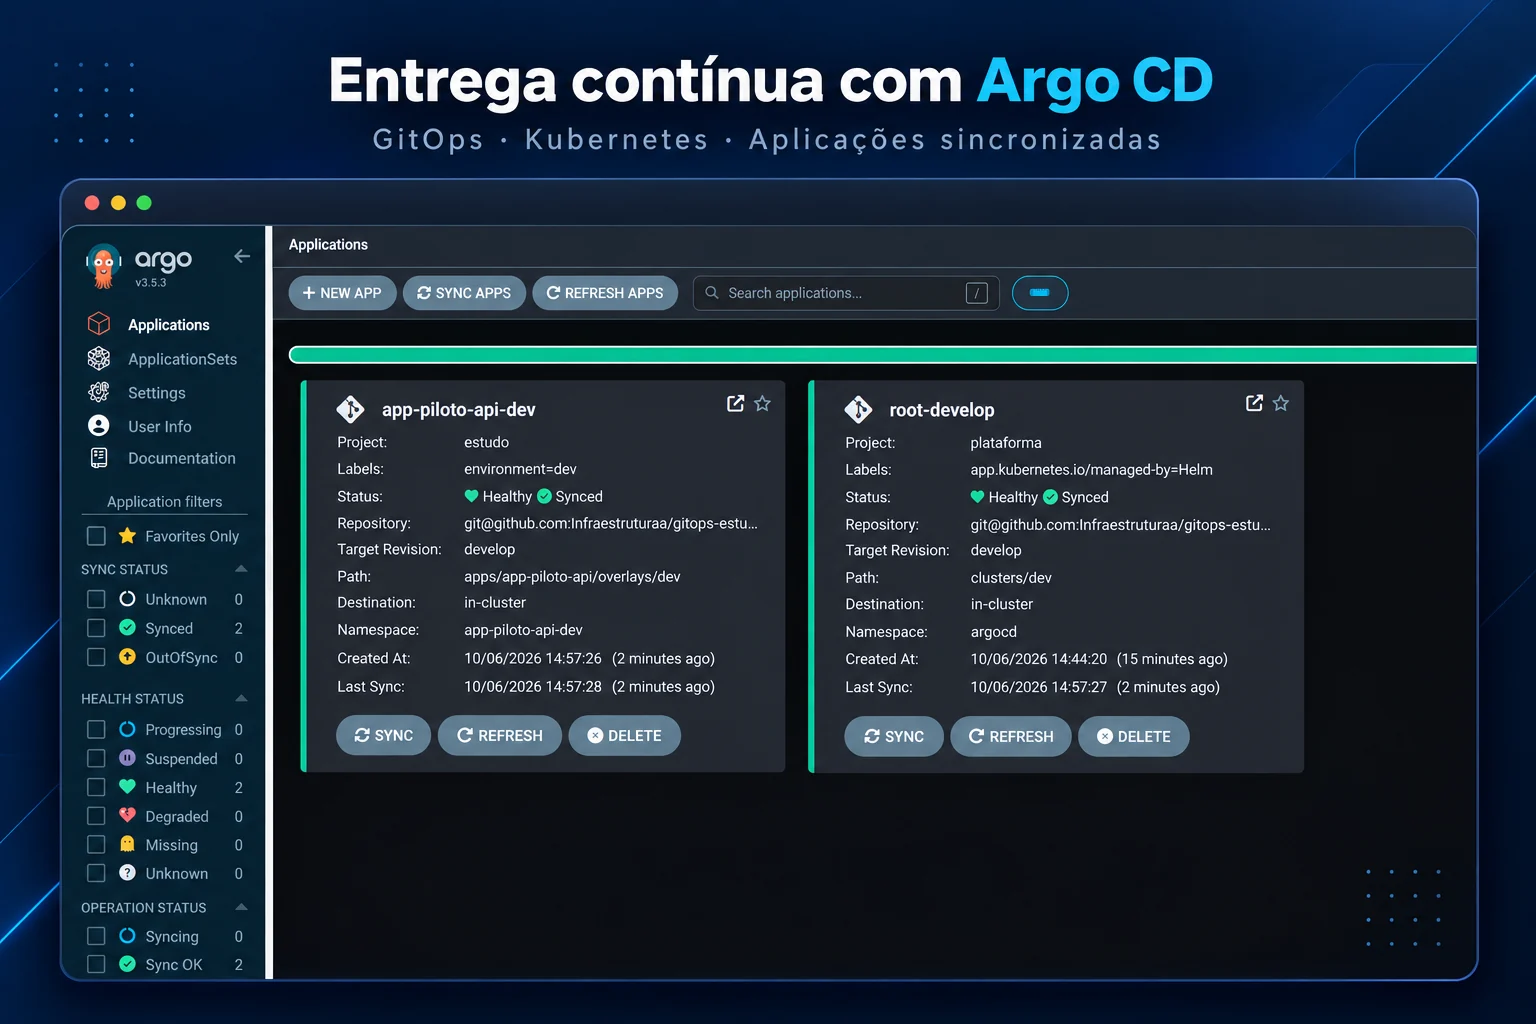
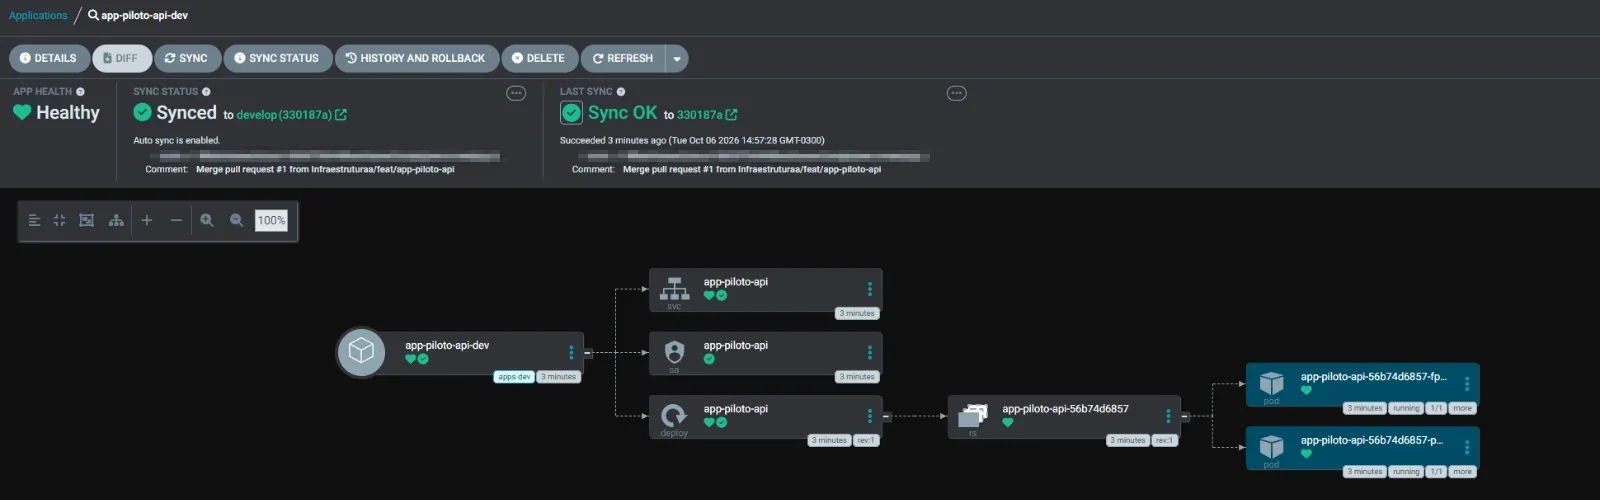
Argo CD com duas aplicações, root-develop e app-piloto-api-dev, ambas Healthy e Synced com o repositório GitOps
Laboratório: a Application raiz lê clusters/dev e o ApplicationSet cria o app da API sozinho. Tudo Healthy e Synced.
Árvore do app no Argo CD: Service, ServiceAccount e Deployment, ReplicaSet e dois pods rodando
O que o Argo CD criou a partir do Git: Service, ServiceAccount, Deployment, ReplicaSet e 2 pods. Synced com o commit da develop.
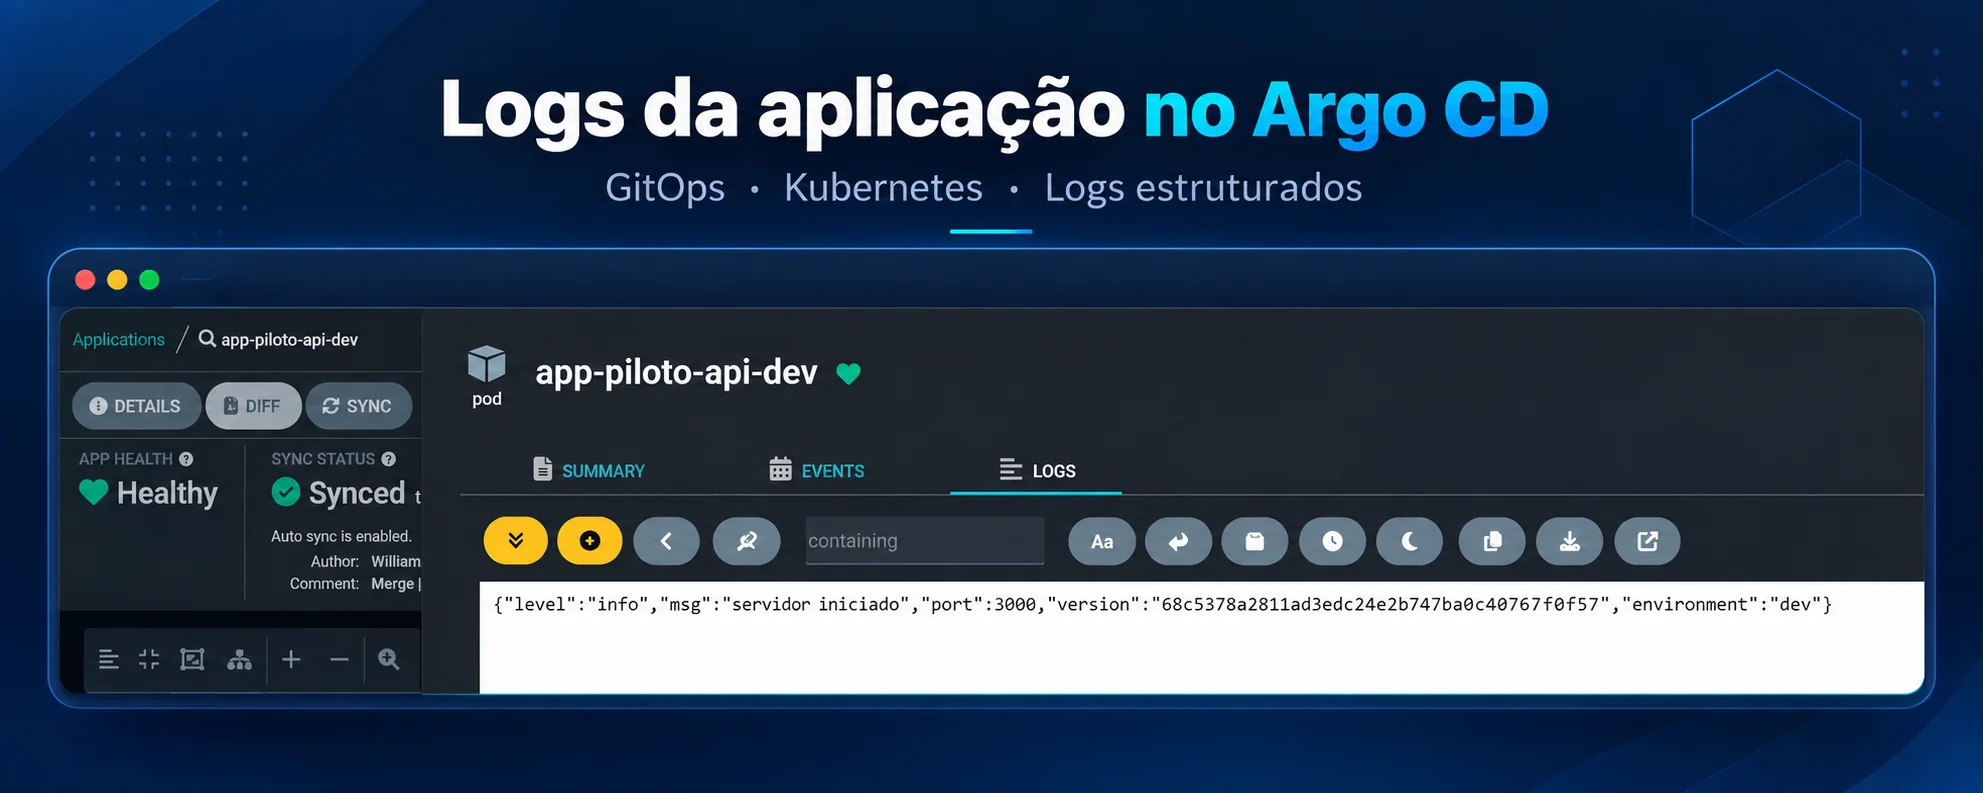
Log do pod mostrando servidor iniciado com a versão igual ao SHA do commit e ambiente dev
Log do pod: a versão é o SHA do commit gravado na imagem, e o ambiente dev vem do overlay do GitOps.
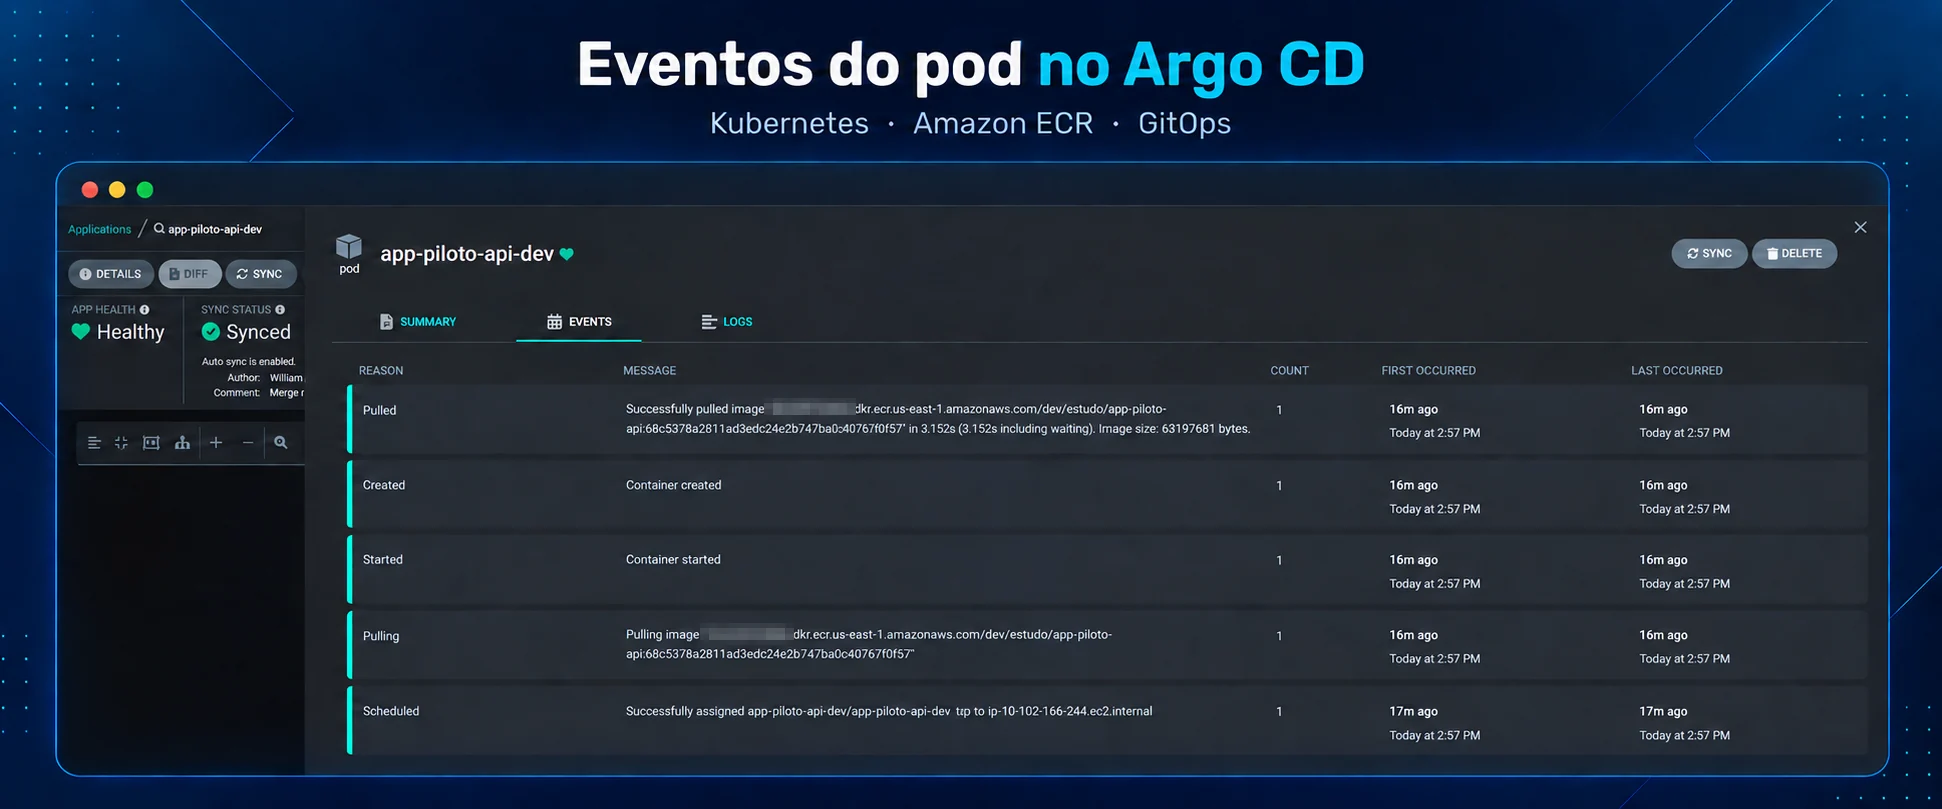
Eventos do pod no Argo CD: imagem baixada do Amazon ECR pela tag do commit, container criado e iniciado
Eventos do pod: o node baixa do ECR a imagem com a tag do commit (3s) e o container sobe. ID da conta borrado.
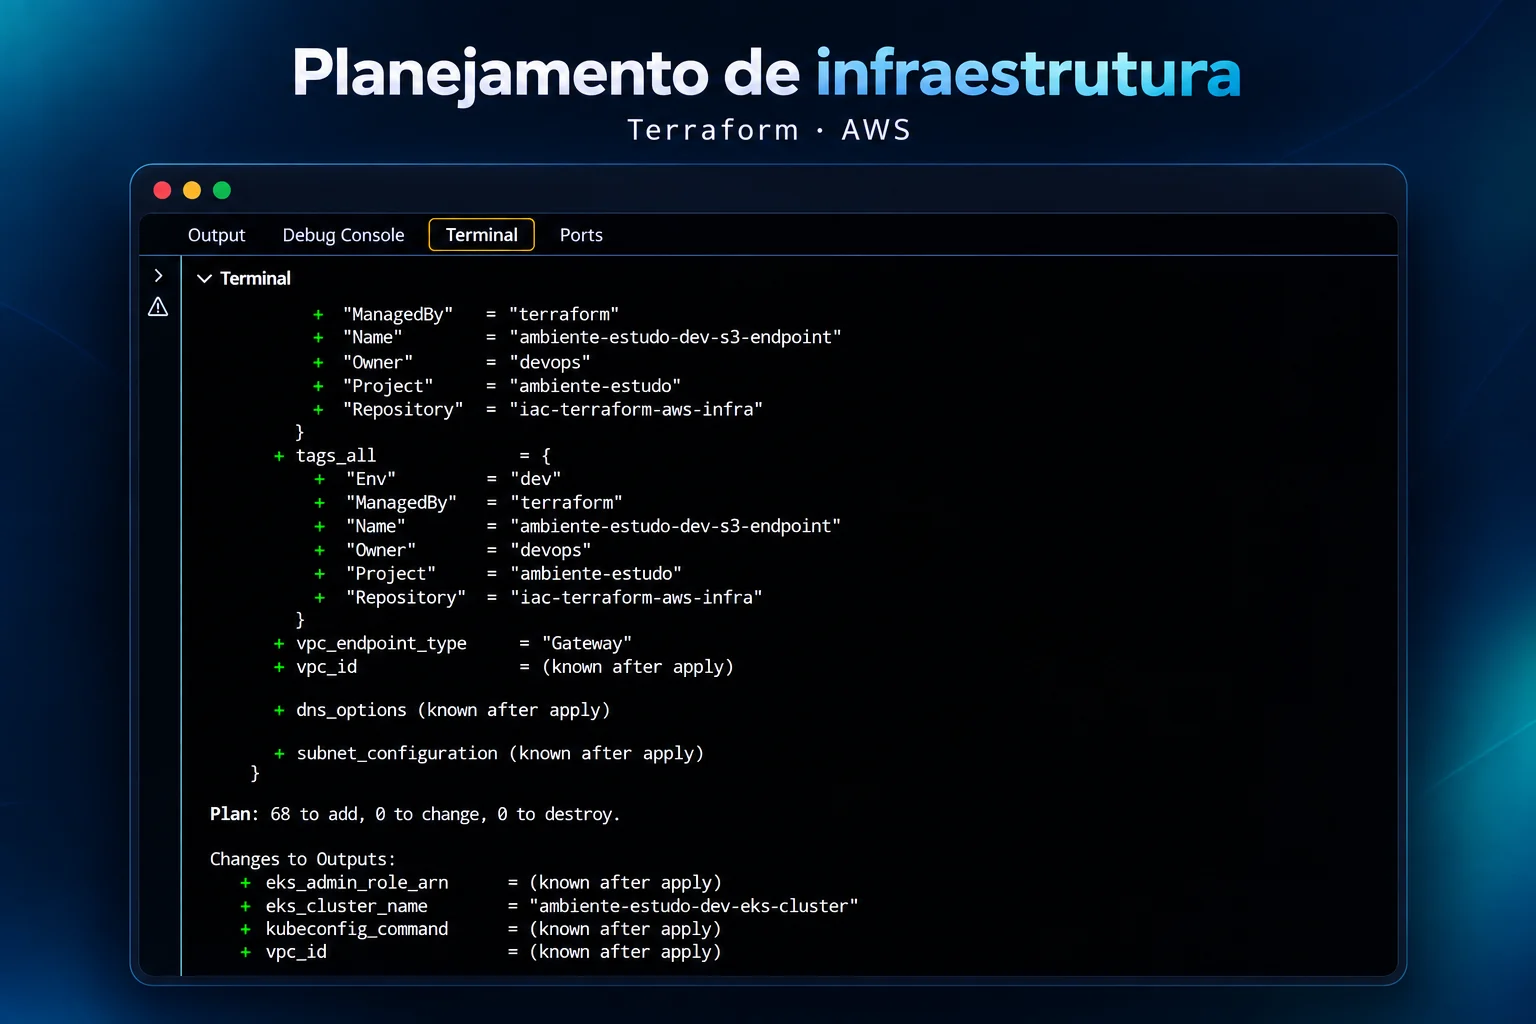
Terraform plan da stack do EKS com 68 recursos para criar e nenhum para mudar ou destruir
Subindo o EKS do zero com Terraform: 68 recursos, nada alterado nem destruído.
Terraform plan da stack do Argo CD com dois releases Helm e os projetos restritos ao repositório GitOps
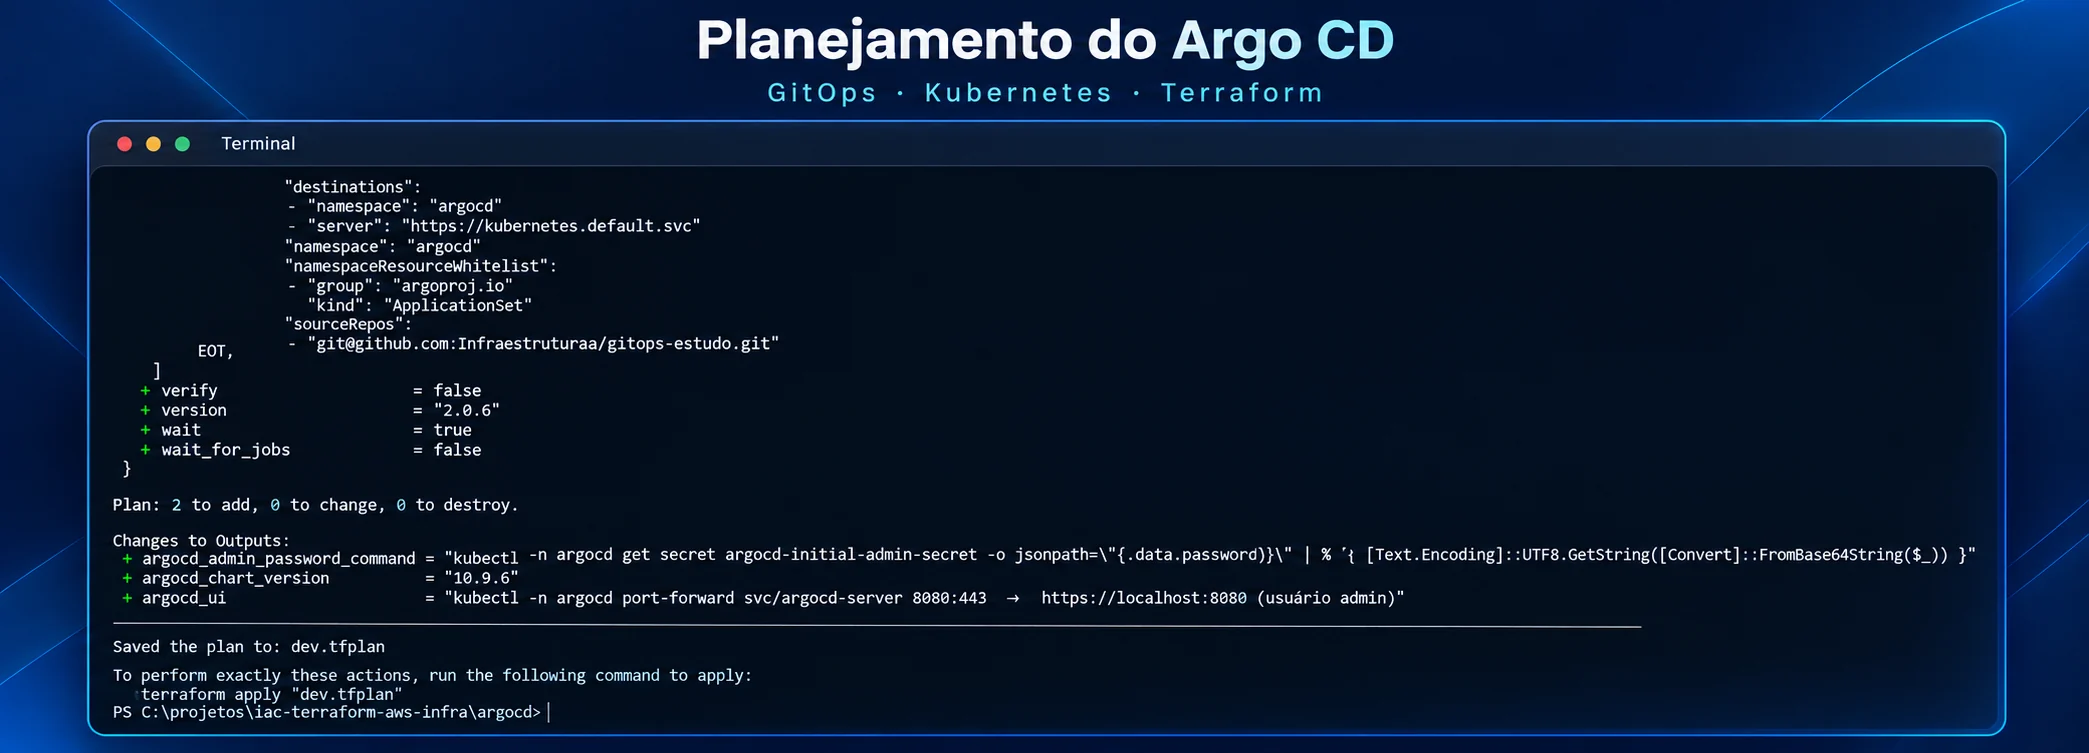
Argo CD instalado por Terraform (stack separada): 2 releases Helm, projetos restritos ao repositório GitOps.
Argo CDKustomizeAmazon EKSGitHub ActionsECRAWS OIDC
04

BANCO DE DADOS · CUSTO · AWS

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Banco no Aurora Serverless: paga pelo uso e a AWS cuida do resto

Migração para o Aurora Serverless v2: o banco cresce e diminui sozinho conforme a demanda, o custo acompanha o uso e a AWS assume a parte pesada da operação.

DESAFIO

Um banco provisionado fica ligado com o mesmo tamanho o dia inteiro, mesmo quando quase ninguém está usando. A conta vem cheia nas horas paradas, e aguentar um pico exige planejar capacidade com antecedência.

SOLUÇÃO

Levei o banco para o Aurora PostgreSQL Serverless v2. A capacidade é medida em ACUs e a AWS ajusta sozinha, em segundos, entre um mínimo e um máximo que eu defino. A senha do administrador fica gerenciada pela AWS no Secrets Manager, a conexão exige SSL e tudo está descrito em Terraform.

RESULTADO

O custo passa a acompanhar o uso real, sem pagar por capacidade parada, e o banco acompanha a demanda sem ninguém precisar mexer. Backups, atualizações e alta disponibilidade ficam com a AWS, e o time foca na aplicação.

banco.yaml•••

01banco:

02  motor: aurora_postgresql_serverless_v2

03  cobranca: por_uso

04  capacidade:

05    escala: automatica # em segundos

06    limites: "minimo e maximo definidos"

07  senha_admin: gerenciada_pela_aws

08  ssl: obrigatorio

09  a_cargo_da_aws:

10    - backups

11    - atualizacoes

12    - alta_disponibilidade

13  infra: terraform

14status: "paga_pelo_que_usa"

mainUTF-8Ln 14

Código real do projeto

O essencial do Aurora Serverless v2 em Terraform: escala automática, senha gerenciada pela AWS e criptografia.

resource "aws_rds_cluster" "app" {
  cluster_identifier = "app-db"
  engine             = "aurora-postgresql"
  engine_mode        = "provisioned"   # Serverless v2 usa o modo provisioned + scaling
  database_name      = "app"
  master_username    = "app_admin"

  # a AWS cria, guarda e gira a senha no Secrets Manager
  manage_master_user_password = true

  storage_encrypted       = true
  backup_retention_period = 7

  serverlessv2_scaling_configuration {
    min_capacity = 0.5   # ACUs: o banco encolhe quando o uso cai
    max_capacity = 4     # ...e cresce sozinho no pico
  }
}

resource "aws_rds_cluster_instance" "app" {
  cluster_identifier = aws_rds_cluster.app.id
  instance_class     = "db.serverless"
  engine             = aws_rds_cluster.app.engine
}
Aurora Serverless v2PostgreSQLSecrets ManagerTerraform
05

CI/CD · PADRONIZAÇÃO

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Um pipeline para vários repositórios: workflows reutilizáveis e versionados

Em vez de copiar o mesmo YAML em cada repositório, criei um repositório central de workflows que os projetos chamam por versão, como se fosse uma biblioteca.

DESAFIO

Cada repositório tinha o seu próprio pipeline, copiado e colado de outro. Corrigir um problema significava abrir o mesmo PR em vários lugares, e com o tempo cada cópia ia ficando diferente da outra.

SOLUÇÃO

Juntei os passos comuns (build, testes, segurança e deploy) em workflows reutilizáveis num repositório central. Cada projeto chama com poucas linhas e escolhe a versão pela tag, seguindo SemVer: mudança que quebra compatibilidade vira versão major. Tudo é configurável por inputs e não tem segredo no código, porque o acesso à AWS é por OIDC.

RESULTADO

Um ajuste no pipeline é feito uma vez só e chega aos projetos quando eles sobem de versão, no tempo de cada um. Um app novo ganha CI e deploy completos com um arquivo curto. Este próprio site usa esse modelo.

ci.yml•••

01jobs:

02  ci:

03    uses: "org/workflows/ci-node.yml@v1.0.0"

04    with:

05      node_version: "22"

06      lint_command: "npm run lint"

07      test_command: "npm test"

08pipelines_copiados: 0 # um só, versionado

09segredos_no_codigo: 0

10status: "padronizado"

mainUTF-8Ln 10

Código real do projeto

O CI deste próprio site: chama o workflow central e só diz o que é diferente aqui.

name: CI

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

concurrency:              # novo push no PR cancela a validação anterior
  group: ci-${{ github.ref }}
  cancel-in-progress: true

jobs:
  ci:
    uses: minha-org/github-actions-workflows/.github/workflows/ci-node.yml@v1.0.0
    with:
      node_version: "22"
      lint_command: "npm run lint"
      test_command: "npm test"   # build + HTML renderizado + headers de segurança
GitHub ActionsWorkflows reutilizáveisSemVerOIDC
06

SEGURANÇA · IDENTIDADE AWS

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Quando o GitHub mudou o login na AWS: OIDC com IDs imutáveis

O deploy passou a ser recusado pela AWS de uma hora para outra. O motivo era um formato novo no token do GitHub. Diagnostiquei pelo CloudTrail e ajustei o módulo Terraform.

DESAFIO

O pipeline entrava na AWS por OIDC, sem nenhuma chave guardada. Um dia começou a dar AccessDenied. A role confiava num formato de identificação do repositório, mas o token passou a chegar com o ID numérico da organização e do repositório junto do nome.

SOLUÇÃO

Fui ao CloudTrail, encontrei o evento AssumeRoleWithWebIdentity e comparei o que tinha chegado com o que a role esperava. Ajustei o módulo de OIDC para montar a condição no formato novo, com validação por regex, e publiquei como uma nova versão do módulo.

RESULTADO

O deploy voltou a funcionar e ficou mais seguro: o ID não muda se alguém renomear ou recriar um repositório com o mesmo nome, então ninguém consegue herdar a permissão por engano. A trava de branch continua: deploy pela branch errada, a AWS recusa.

oidc.yaml•••

01login_aws:

02  metodo: oidc

03  chaves_guardadas: 0

04  confia_em:

05    antes: "repo:org/app:ref:..."

06    agora: "repo:org@id/app@id:ref:..."

07  diagnostico: cloudtrail # AssumeRoleWithWebIdentity

08  branch_errada: recusada

09status: "deploy_liberado"

mainUTF-8Ln 9

Código real do projeto

Como o repositório passou a aparecer no token do GitHub, e o Terraform montando os dois formatos.

locals {
  # Como o repositório aparece no "sub" do token OIDC do GitHub:
  # - com IDs imutáveis: minha-org@<org_id>/app-front@<repo_id>
  # - formato antigo:    minha-org/app-front
  oidc_repository = {
    front = (
      var.github_org_id != null && var.front.repository_id != null
      ? "${var.github_org}@${var.github_org_id}/${var.front.repository}@${var.front.repository_id}"
      : "${var.github_org}/${var.front.repository}"
    )
  }
}
AWS IAMOIDCCloudTrailTerraformGitHub Actions
07

CONTAINERS · SEGURANÇA

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Imagem Docker de 26 vulnerabilidades para zero

O scanner barrou a imagem da API no pipeline. Em vez de desligar o scanner, ajustei a imagem até ela passar limpa.

DESAFIO

O Trivy roda no pipeline e barra vulnerabilidades HIGH e CRITICAL. Ele reprovou a imagem da API, mas os problemas nem eram do código da aplicação: vinham do npm que já vem dentro da imagem base e de bibliotecas do sistema desatualizadas. E a versão do Node usada já tinha chegado ao fim do suporte.

SOLUÇÃO

Reescrevi o Dockerfile em multi-stage: uma etapa para preparar e outra, enxuta, só com o que é preciso para rodar. Na imagem final removi npm, yarn e corepack, que a aplicação não usa em produção, atualizei os pacotes do sistema e subi para o Node 22.

RESULTADO

A imagem saiu de 26 vulnerabilidades para zero e ficou mais enxuta. O scanner continua ligado e barrando: segurança virou parte do caminho, não uma etapa opcional.

imagem.yaml•••

01imagem:

02  vulnerabilidades: "26 -> 0"

03  base: "node:22-alpine"

04  build: multi_stage

05  removidos_da_imagem_final:

06    - npm

07    - yarn

08    - corepack

09  sistema: atualizado # apk upgrade

10  scanner: trivy # barra HIGH e CRITICAL

11status: "aprovada"

mainUTF-8Ln 11

Código real do projeto

Multi-stage: o npm só existe na etapa de instalação; a imagem final leva só o Node e o app.

# syntax=docker/dockerfile:1

# Estágio 1: instala as dependências de produção (o npm fica só aqui)
FROM node:22-alpine AS deps
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci --omit=dev --no-audit --no-fund

# Estágio 2: só o Node + o app
FROM node:22-alpine AS runtime
ENV NODE_ENV=production PORT=3000

# correções de segurança do Alpine + remove ferramentas de build
RUN apk upgrade --no-cache \
 && rm -rf /usr/local/lib/node_modules/npm \
           /usr/local/lib/node_modules/corepack \
           /usr/local/bin/npm /usr/local/bin/npx /usr/local/bin/corepack \
           /usr/local/bin/yarn /usr/local/bin/yarnpkg /opt/yarn-*

WORKDIR /app
COPY --from=deps --chown=node:node /app/node_modules ./node_modules
COPY --chown=node:node package.json ./
COPY --chown=node:node src ./src

USER node   # nunca rodar como root dentro do container
EXPOSE 3000
HEALTHCHECK --interval=30s --timeout=3s CMD wget -qO- http://127.0.0.1:3000/health || exit 1
CMD ["node", "src/server.js"]
DockerTrivyNode.js 22AlpineECR
08

PLATAFORMA · AWS · KUBERNETES

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Plataforma EKS com GitOps para múltiplos ambientes

Uma plataforma Kubernetes para dezenas de microsserviços, em quatro ambientes, onde o deploy é um commit e dá para ver o que cada versão está fazendo.

DESAFIO

Eram dezenas de aplicações passando por desenvolvimento, homologação, staging e produção. Cada ambiente acabava um pouco diferente do outro, e muita coisa ainda dependia de alguém fazer na mão.

SOLUÇÃO

Montei o EKS com Terraform e coloquei o Argo CD com ApplicationSets para cuidar dos deploys. O tráfego entra pelo AWS Load Balancer Controller, os segredos ficam no Secrets Manager e o Datadog acompanha tudo. Cada versão vira uma imagem que não muda mais, e ela sobe de ambiente pela branch.

RESULTADO

O deploy parou de ser surpresa: o que está no Git é o que está rodando. Dá para recriar um ambiente do zero, e quando algo quebra fica mais fácil saber se o problema é da aplicação ou da infraestrutura.

Amazon EKSTerraformArgoCDGitHub ActionsDatadog
09

SEGURANÇA · IDENTIDADE AWS

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Migração de access keys para IRSA no EKS

Tirei as access keys de dentro das aplicações. Agora cada pod recebe uma credencial temporária, só com a permissão que precisa.

DESAFIO

As aplicações liam e gravavam no S3 com chaves fixas guardadas em secrets. Se uma chave vazasse, ela valia até alguém lembrar de trocar, e trocar dava trabalho.

SOLUÇÃO

Criei uma role por aplicação com IRSA, cada uma com a policy mínima, e deixei o próprio AWS SDK buscar a credencial. Só depois de validar que tudo funcionava eu apaguei as chaves do código e dos secrets.

RESULTADO

Não existe mais chave fixa para vazar. Cada aplicação só acessa o que é dela, e no CloudTrail dá para ver exatamente quem fez o quê.

Código real do projeto

Cada aplicação tem o seu ServiceAccount, com a anotação apontando para a role dela. Nenhuma chave no manifest.

apiVersion: v1
kind: ServiceAccount
metadata:
  name: api-pagamentos
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::<conta>:role/dev-api-pagamentos-irsa
AWS IAMIRSAEKSS3Terraform
10

AWS · CONTEÚDO PRIVADO

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

S3 privado com CloudFront e URLs assinadas

Documentos e imagens privados entregues pelo CloudFront, com o bucket fechado para o mundo.

DESAFIO

Algumas aplicações precisavam entregar arquivos privados aos usuários. Abrir o bucket estava fora de questão, e as URLs pré-assinadas do próprio S3 não resolviam bem o caso.

SOLUÇÃO

Deixei os buckets privados, com acesso só pelo CloudFront via Origin Access Control. Cada aplicação ganhou o seu behavior, os links passaram a ser Signed URLs do CloudFront e quem envia arquivo não é quem distribui.

RESULTADO

O arquivo só abre com link válido e por tempo limitado, e o bucket nunca fica exposto. Toda aplicação nova segue o mesmo modelo.

Amazon S3CloudFrontOACSigned URLIAM
11

OBSERVABILIDADE · SRE

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Observabilidade de microsserviços com Datadog

Métricas, logs, traces e a versão de cada serviço no mesmo lugar, para achar a causa de um problema no Kubernetes sem caçar em cinco telas.

DESAFIO

Com muitos serviços conversando entre si, quando algo falhava a pergunta era sempre a mesma: foi o código, a versão nova ou a infraestrutura? E a resposta demorava.

SOLUÇÃO

Instalei o Datadog Operator e padronizei as tags de serviço, ambiente e versão em todas as aplicações. O pipeline passou a marcar a versão a cada deploy, e montei dashboards e alertas em cima disso.

RESULTADO

Hoje dá para ver na hora se um erro começou junto com um deploy, e de qual serviço ele veio.

DatadogKubernetesAPMLogsMétricas
12

INFRAESTRUTURA COMO CÓDIGO

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Infraestrutura reutilizável em AWS, Azure e GCP

Rede, identidade e serviços descritos em Terraform, para que um ambiente novo saia igual ao anterior.

DESAFIO

Boa parte da infraestrutura tinha sido criada no console, na mão. Ninguém sabia direito por que um ambiente era diferente do outro.

SOLUÇÃO

Escrevi módulos Terraform reutilizáveis, com variáveis por ambiente e state remoto, e coloquei a validação no pipeline: toda mudança passa por um plan revisado antes do apply.

RESULTADO

Mudança de infraestrutura virou pull request, com histórico e revisão. Subir um ambiente novo deixou de ser um projeto.

TerraformAWSAzureGCPCI/CD
13

FRONTEND · CLOUD

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Publicação de microfrontends em S3 e CloudFront

Cada microfrontend publica sozinho no S3 e CloudFront, sem o usuário pegar arquivo velho do cache.

DESAFIO

Os microfrontends eram publicados separados, e às vezes o CloudFront continuava entregando o index.html ou o remoteEntry.js antigo. Resultado: tela quebrada depois do deploy.

SOLUÇÃO

Fiz os pipelines entrarem na AWS por OIDC, separei a política de cache por tipo de arquivo (o que muda sempre quase não fica em cache), coloquei invalidação no fim do deploy e um behavior do CloudFront para cada microfrontend.

RESULTADO

Cada time publica no seu ritmo, o bucket continua privado e a tela quebrada por cache antigo deixou de aparecer depois dos deploys.

S3CloudFrontGitHub ActionsOIDCReact
14

MICROSOFT · ENDPOINTS

EXPERIÊNCIA PROFISSIONAL · PRINTS DE LABORATÓRIO

Dispositivos e segurança no Microsoft 365

Antes do DevOps: cuidar dos computadores, da proteção e dos serviços Microsoft que a empresa usava todo dia.

DESAFIO

Muitos dispositivos e usuários para manter configurados, protegidos e funcionando, sem atrapalhar o trabalho de ninguém.

SOLUÇÃO

Usei o Intune para aplicar políticas nos dispositivos, o Defender para protegê-los e dei suporte ao Microsoft 365 no dia a dia.

RESULTADO

Os dispositivos passaram a seguir o mesmo padrão, as ameaças eram barradas antes de virar problema e o usuário tinha menos dor de cabeça.

Microsoft IntuneMicrosoft DefenderMicrosoft 365Azure