Isso aconteceu no meu laboratório de estudo em 8 de outubro de 2026. Os prints são reais; o ambiente foi destruído no mesmo dia.
01 / O OBJETIVO
Um app no ar não prova muita coisa.
Ver uma API ficar verde no Argo CD é legal, mas não responde as perguntas que importam numa empresa: dá para colocar app novo sem mexer na plataforma? O cluster aguenta pico de acesso? E se alguém mexer na mão, o que acontece?
Fui atrás de responder cada uma com um print.
02 / SUBINDO
Um script, e um bug que só apareceu no Windows.
Antes de começar, escrevi um script para subir o EKS e o Argo CD na ordem certa, com confirmação antes de cada apply. Ele funcionou até a última etapa, quando a conferência dos apps quebrou:
error: error parsing jsonpath {range .items[*]}...{\n}{end},
unrecognized character in action: U+005C '\'
O PowerShell do Windows remove as aspas ao chamar programas externos. No meu teste usei o PowerShell 7, que não tem esse problema. A correção foi parar de passar expressão com aspas para o kubectl: o script agora lê o resultado em JSON e filtra no próprio PowerShell.
03 / APP NOVO = PASTA
Três apps novos sem tocar no Argo CD.
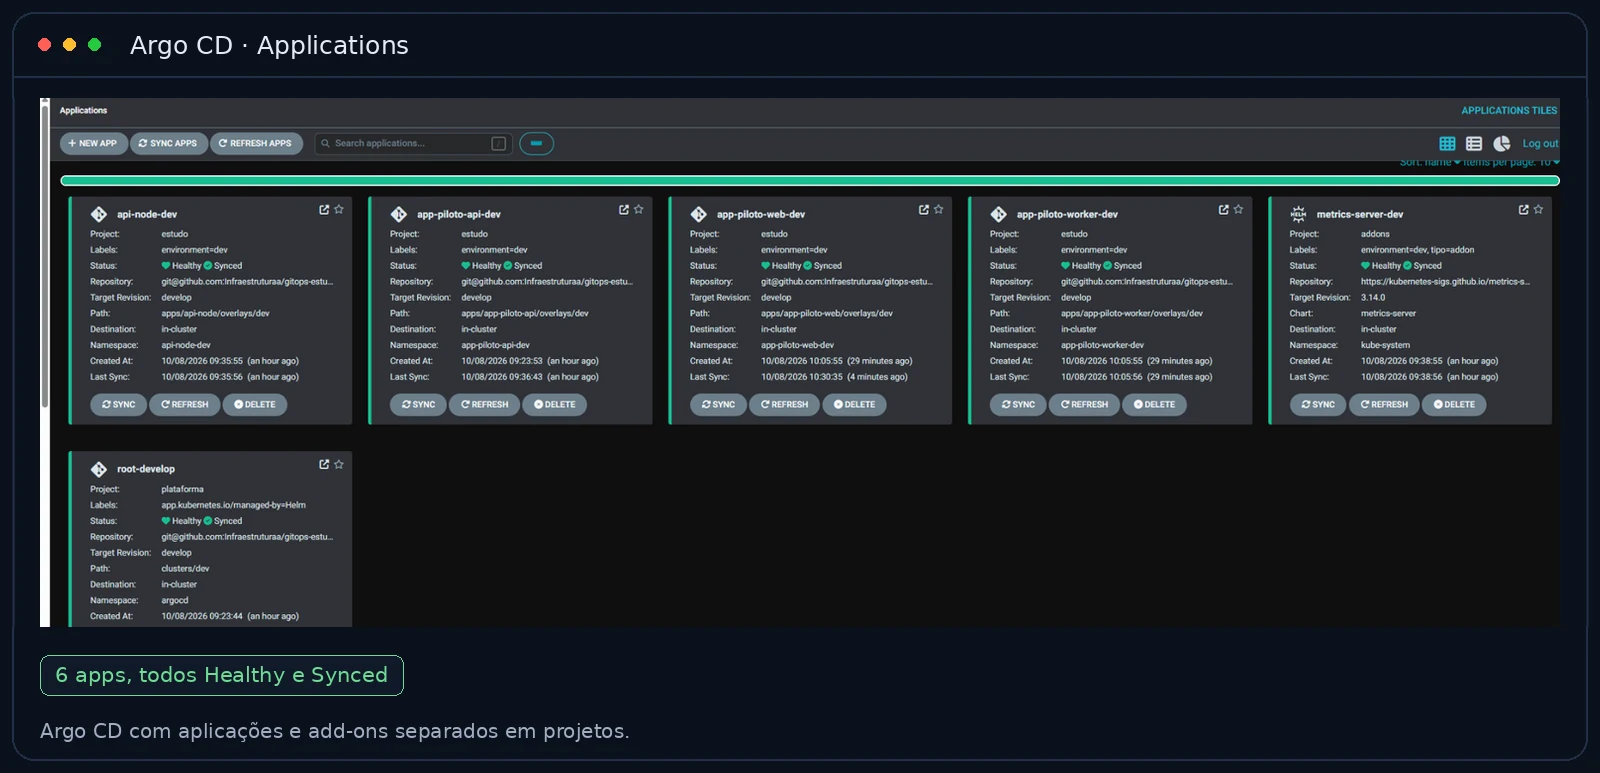
O ApplicationSet cria um app para cada pasta em apps/. Então colocar um app novo é só criar a pasta com os manifests e dar merge. Subi três:
api-node a imagem do meu repositório público docker-node-hardened, direto do GHCR.
app-piloto-web uma página servida por nginx sem root, com esteira própria até o ECR.
app-piloto-worker um CronJob que, a cada 5 minutos, chama a API e registra no log se ela respondeu.
{"level":"info","msg":"checagem de saúde","ok":true,"status":200,"ms":103,
 "version":"46f727fbce7cb695978a151a381e50f3aa54eb78"}
O version no log é o SHA do commit que a esteira publicou. Dá para ir do pod até a linha de código.
O tropeço: dei merge antes da imagem existir
Os manifests entraram no Git antes de a esteira publicar a imagem. O Argo CD fez o que devia, criou o app, e o pod ficou em ImagePullBackOff: a imagem não existia no ECR. Quando a esteira terminou, o Kubernetes tentou de novo e subiu sozinho. A ordem certa é imagem primeiro, tag no Git depois.
04 / ADD-ONS
Plataforma e aplicação não moram no mesmo projeto.
O autoscaling precisa do metrics-server, que não é aplicação: é peça da plataforma. Criei um segundo ApplicationSet só para add-ons e um projeto próprio no Argo CD, com regras mais fechadas: só charts Helm aprovados, só no kube-system e só os recursos de cluster que um add-on precisa.
generators:
  - list:
      elements:
        - name: metrics-server
          namespace: kube-system
          repoURL: https://kubernetes-sigs.github.io/metrics-server/
          chart: metrics-server
          version: 3.14.0 # versão fixa: atualizar de propósito
Também errei a ordem aqui: o ApplicationSet entrou antes do projeto existir e a raiz ficou Degraded. Depois do apply do Terraform com o projeto novo, voltou ao verde sem nenhuma intervenção.
05 / AUTOSCALING
2 pods, carga, 4 pods. Carga parou, 2 de novo.
Configurei o HPA da API para manter a CPU em 70% do reservado, entre 2 e 4 pods. Para testar, subi um pod que chamava a API sem parar, simulando quatro usuários ao mesmo tempo.
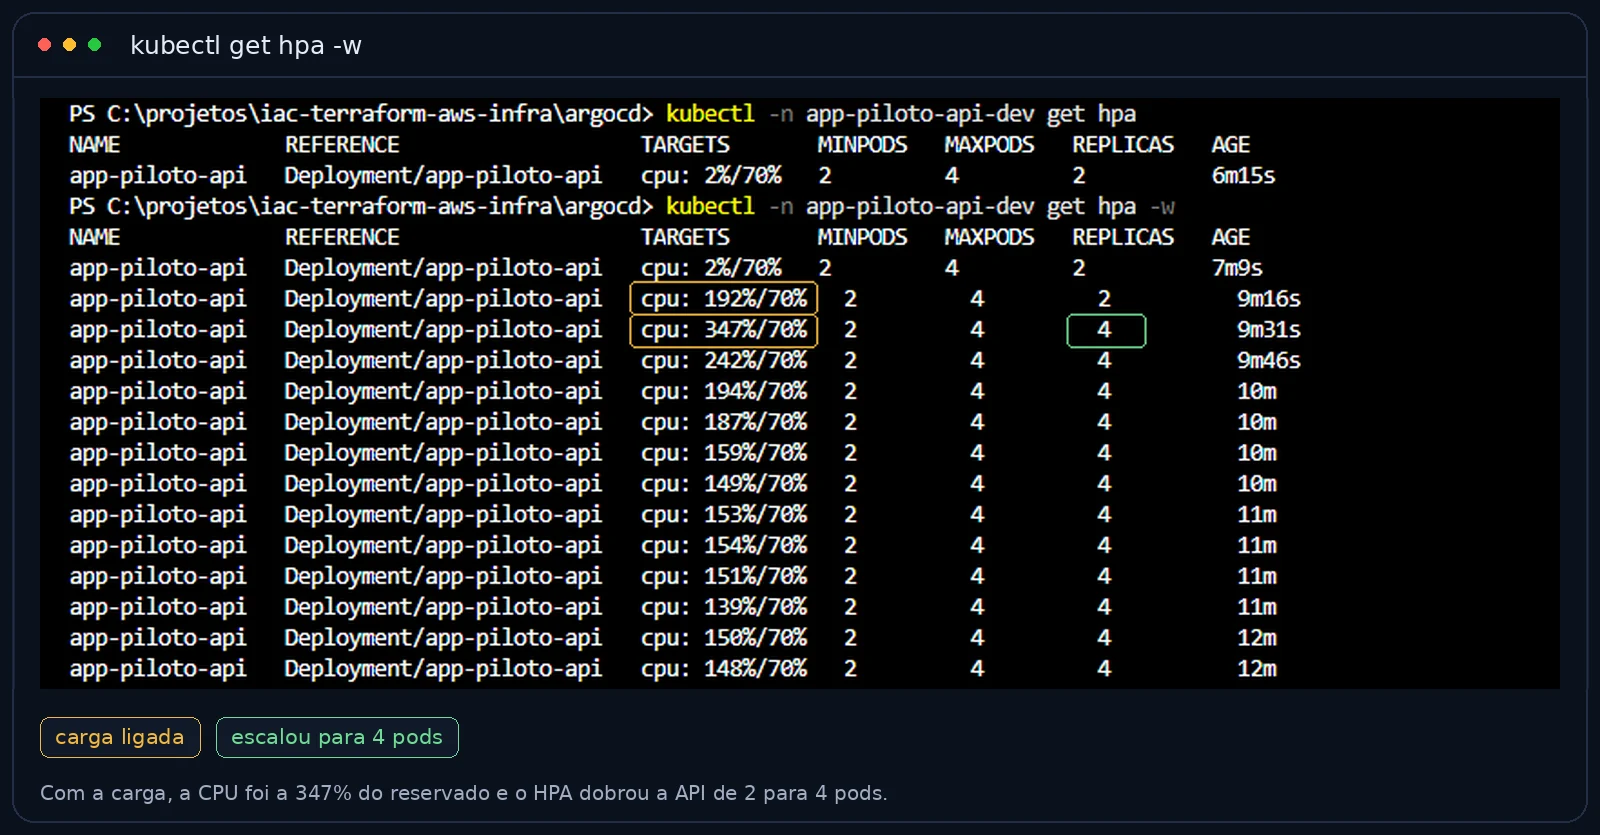
Dois detalhes que valem explicar. Os 347% são em relação ao request do pod (50m), não ao processador inteiro. E a CPU continuou acima de 70% mesmo com 4 pods porque 4 era o limite que eu dei: os nodes do laboratório são pequenos. Num ambiente real, o máximo seria maior e haveria um autoscaler de nodes junto.
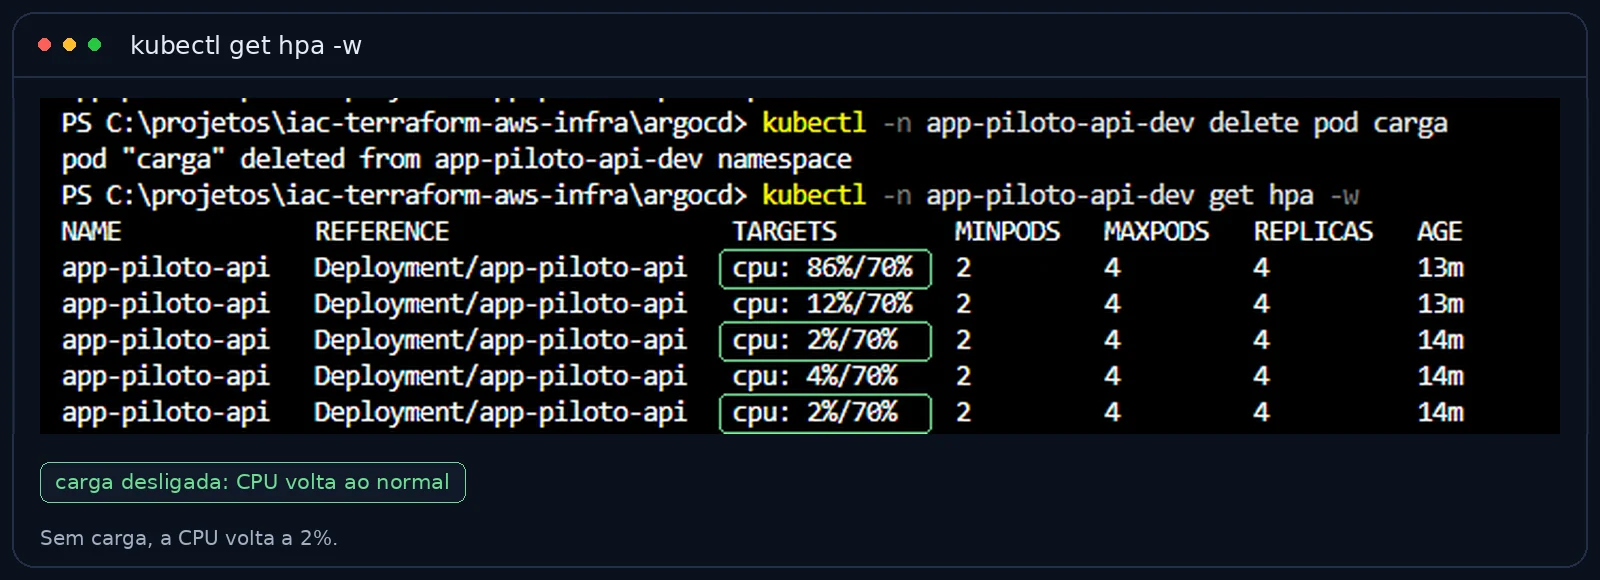
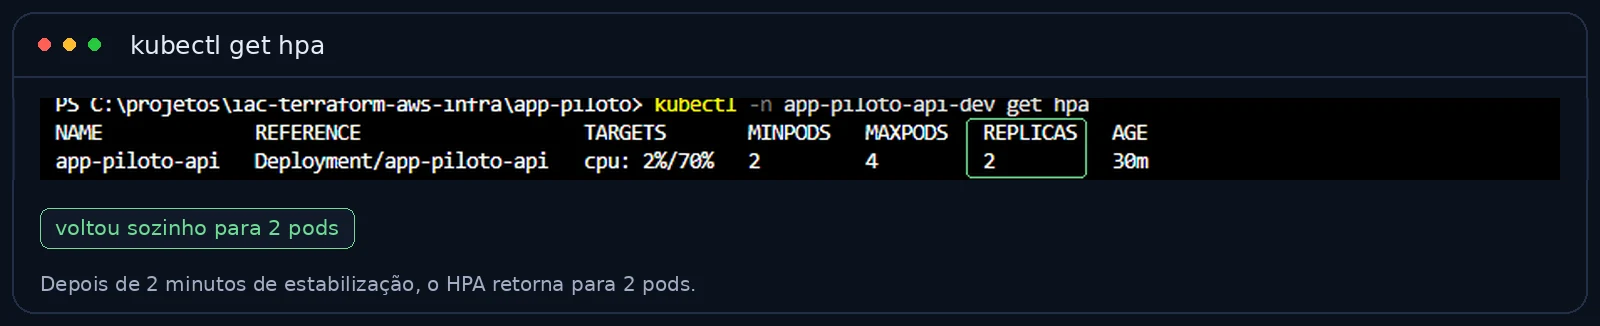
Esses 2 minutos são de propósito. Sem a janela de estabilização, se a carga vier em ondas o HPA fica subindo e derrubando pod o tempo todo.
06 / SELF-HEAL
Apaguei na mão. O Argo CD recriou.
Esse era o teste que eu mais queria ver. Apaguei o Deployment de um app direto no cluster, sem passar pelo Git.
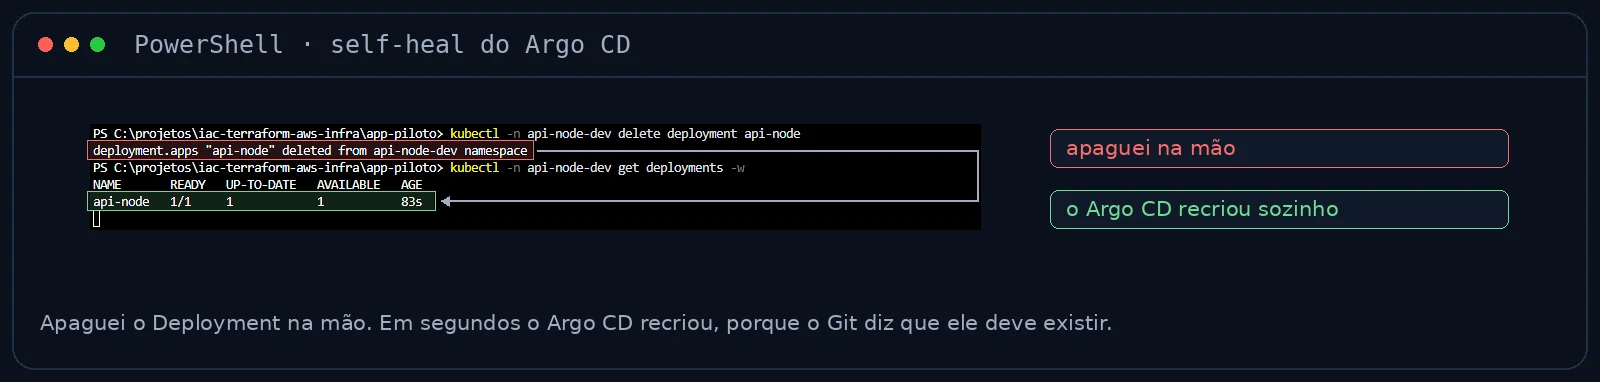
O Argo CD percebeu que o cluster ficou diferente do Git e recriou. Mudança fora do Git não sobrevive, e isso vale tanto para um erro quanto para um "ajuste rápido" que ninguém documentou.
07 / SEM ROOT
A segurança do Dockerfile, conferida no cluster.
Os Dockerfiles dizem que nada roda como root. Em vez de confiar, conferi dentro dos containers:
kubectl -n app-piloto-web-dev exec deploy/app-piloto-web -- id
uid=101(nginx) gid=101(nginx) groups=101(nginx)

kubectl -n app-piloto-api-dev exec deploy/app-piloto-api -- id
uid=1000(node) gid=1000(node) groups=1000(node)
Se alguém conseguir entrar num desses containers, não tem poder de administrador lá dentro. E os manifests ainda reforçam: filesystem somente leitura, drop ALL e nenhum token do Kubernetes montado no pod.
08 / APRENDIZADOS
O que eu levo dessa.
- 01
Ordem importa
imagem antes da tag; projeto do Argo CD antes do ApplicationSet que usa ele. Nos dois casos o sistema se recuperou sozinho, mas a ordem certa evita o susto.
- 02
Teste no ambiente de quem vai usar
o script passou no meu PowerShell 7 e quebrou no 5.1 do Windows.
- 03
Limite é decisão
o HPA parou em 4 pods porque eu mandei. Saber onde está o teto faz parte de configurar autoscaling.
- 04
Confiar, mas conferir
self-heal e usuário sem root viraram print, não só promessa no README.
O próximo passo é fechar o ciclo: a esteira commitando a tag nova sozinha com um GitHub App, e segredos vindo do Secrets Manager pelo External Secrets.
william@devops:~$ echo $LESSON_LEARNED
"O Git diz como o cluster deve estar. O resto é o Argo CD cuidando disso."